Qué es arXiv y por qué se ha vuelto imprescindible
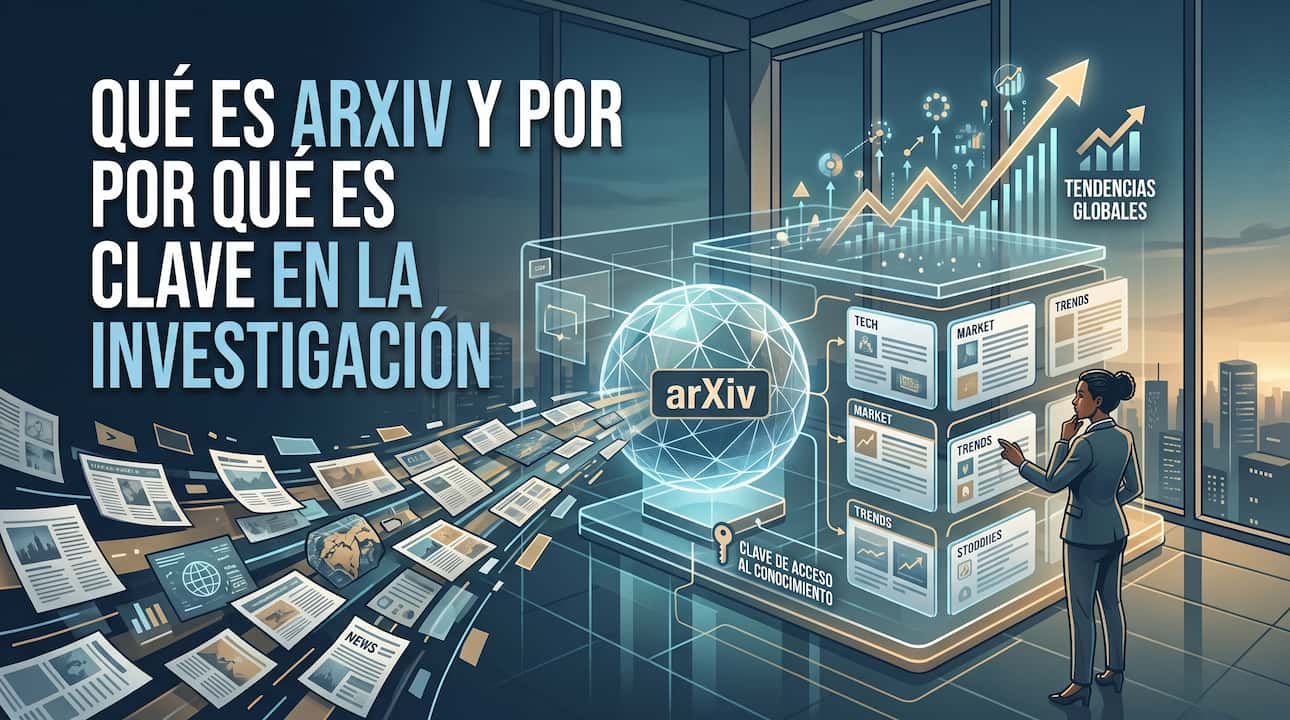
Cada día, cientos de investigadores de todo el mundo comparten sus resultados antes de que una revista científica los publique. El lugar donde ocurre ese intercambio, en su gran mayoría, es arXiv (pronunciado «arcáiv»), un repositorio gratuito de preprints que se ha convertido en la infraestructura informativa más influyente de las ciencias exactas y la computación.
Entender qué es arXiv y cómo funciona resulta cada vez más relevante para estudiantes, docentes e investigadores de Latinoamérica: no solo porque concentra el conocimiento más reciente de disciplinas como la inteligencia artificial, sino porque su modelo de acceso abierto elimina las barreras de pago que tanto limitan a las universidades de la región.
¿Qué es arXiv y cómo funciona?
arXiv es un repositorio digital donde investigadores suben versiones preliminares de sus artículos científicos, conocidas como preprints o preimpresiones. A diferencia de una revista académica tradicional, arXiv no realiza una revisión por pares exhaustiva: un equipo de moderadores voluntarios verifica que el contenido sea pertinente y cumpla normas básicas de calidad, y el artículo queda disponible públicamente en cuestión de horas o días.
La clave del modelo está en la velocidad. En disciplinas donde los avances ocurren semana a semana —como el aprendizaje automático o la física de partículas— esperar meses al proceso editorial de una revista significaba que el conocimiento llegara tarde. arXiv resolvió ese problema en 1991, cuando el físico Paul Ginsparg creó el servicio para que la comunidad de física de altas energías compartiera resultados de forma inmediata.
¿Cuánto contenido aloja arXiv hoy?
El crecimiento de la plataforma resulta difícil de exagerar. En abril de 2026, arXiv superó los 3 millones de artículos alojados, solo cuatro años después de haber alcanzado los 2 millones. El ritmo de envíos sigue acelerándose: el récord mensual se ha batido repetidamente en 2026, con más de 32.000 nuevos envíos en junio, lo que equivale a un promedio superior a mil artículos nuevos cada día. La plataforma recibe además más de 5 millones de usuarios activos mensuales. Para dimensionar el fenómeno: en su primer mes de existencia, en 1991, arXiv recibió menos de 30 envíos.
Áreas temáticas y organización del repositorio
arXiv se organiza en ocho áreas principales: física, matemáticas, informática, estadística, biología cuantitativa, finanzas cuantitativas, ingeniería eléctrica y ciencias de sistemas, y economía. Dentro de cada área existen subcategorías más específicas; la de inteligencia artificial (cs.AI) y la de aprendizaje automático (cs.LG) concentran hoy una fracción enorme del volumen total de envíos.
Cada artículo recibe un identificador único permanente (por ejemplo, arXiv:2605.13831), lo que permite citarlo y localizarlo con precisión incluso antes de su eventual publicación en una revista.
arXiv y la revisión por pares: qué garantiza y qué no
Uno de los malentendidos más frecuentes es creer que un artículo en arXiv ha sido «aprobado» por la comunidad científica. No es así. La moderación de arXiv verifica relevancia temática y criterios formales básicos; solo una minoría de envíos queda retenida (alrededor del 6 %) o rechazada (cerca del 2 %). Esto implica dos cosas:
Lo positivo: cualquier investigador, desde un estudiante de pregrado hasta un premio Nobel, puede difundir su trabajo sin depender de editores ni costos de publicación.
Lo que exige cautela: un preprint puede contener errores, conclusiones prematuras o resultados que nunca superen la revisión por pares de una revista. Varias investigaciones célebres que circularon con impacto mediático en arXiv terminaron refutadas o retiradas posteriormente.
La práctica recomendada es tratar los preprints como resultados provisionales: valiosos para conocer la frontera del conocimiento, pero que deben contrastarse con versiones revisadas por pares cuando existan.
Las nuevas reglas de arXiv en la era de la inteligencia artificial
En 2026, arXiv introdujo cambios significativos que todo usuario de la plataforma debe conocer:
Requisito de inglés completo. Desde febrero de 2026, todos los envíos deben estar escritos íntegramente en inglés o incluir una traducción completa al inglés. Antes bastaba con un resumen en ese idioma. La plataforma .acepta traducciones realizadas con herramientas de IA, pero exige que los autores verifiquen su precisión y asuman la responsabilidad del contenido
Política contra el contenido generado sin verificar. Frente al aumento de artículos con texto producido por modelos de lenguaje, arXiv endureció sus sanciones: los autores que envíen trabajos con evidencia de no haber verificado el contenido generado por IA pueden recibir una suspensión de hasta un año.
Independencia institucional. El 1 de julio de 2026, arXiv se constituyó como organización sin fines de lucro independiente, después de más de 25 años bajo el ala de la Universidad de Cornell.
Estos cambios reflejan una tensión real: la IA acelera la producción de conocimiento, pero también multiplica el ruido. Para los lectores, la habilidad de evaluar críticamente un preprint nunca ha sido tan importante.
¿Qué significa arXiv para la investigación en Latinoamérica?
El modelo de acceso abierto de arXiv tiene un impacto particular en la región, donde muchas universidades públicas no pueden pagar las suscripciones a las grandes editoriales científicas. Un investigador ecuatoriano o peruano accede al mismo preprint, el mismo día y sin costo, que un equipo del MIT o de Oxford.
Sin embargo, existen desafíos que conviene reconocer:
-
Barrera lingüística. La exigencia de inglés completo intensifica la necesidad de dominio del idioma en la formación de investigadores latinoamericanos.
-
Brecha de uso. Acceder al contenido es solo el primer paso; interpretar preprints avanzados exige preparación metodológica que la educación formal de la región no siempre garantiza.
-
Visibilidad asimétrica. Aunque cualquiera puede publicar en arXiv, la infraestructura institucional que respalda la investigación de calidad —laboratorios, financiamiento, mentoría— sigue concentrada en Estados Unidos, Europa y, cada vez más, Asia.
Precisamente por eso, aprender a usar arXiv de forma estratégica es una habilidad diferenciadora: permite a estudiantes y docentes de la región incorporarse a conversaciones científicas globales sin intermediarios.
Cómo aprovechar arXiv de forma práctica
Más allá de visitar el sitio ocasionalmente, existen formas de integrar arXiv al trabajo académico cotidiano:
Búsqueda y alertas. El buscador de arXiv permite filtrar por categoría, fecha y autor. Configurar alertas por correo electrónico o RSS en subtemas específicos (por ejemplo, procesamiento de lenguaje natural o educación computacional) ofrece un monitoreo automático de la literatura reciente.
Versiones HTML. Muchos artículos recientes incluyen versión HTML navegable, más accesible que el PDF tradicional y mejor adaptada a lectores de pantalla.
API y herramientas externas. arXiv ofrece una API pública que permite construir buscadores personalizados, integrar resultados en gestores de referencias o alimentar revisiones bibliográficas automatizadas.
Buenas prácticas al citar. Al citar un preprint conviene indicar su condición («preprint, no revisado por pares»), verificar si existe una versión publicada posteriormente y conservar el número de identificador de arXiv, ya que los artículos pueden actualizarse en varias versiones.
Un uso frecuente en docencia universitaria es asignar la lectura de preprints recientes como material complementario de cursos de posgrado, lo que acerca a los estudiantes a la investigación vigente mucho antes de que llegue a los libros de texto.
Errores frecuentes al usar preprints
-
Confundir preprint con verdad científica establecida. Un resultado en arXiv es un avance reportado, no un consenso.
-
Ignorar las versiones. Los autores actualizan sus artículos; citar la versión 1 cuando existe una versión 4 corregida puede reproducir errores ya subsanados.
-
Descartar el contexto institucional. Un preprint de un grupo reconocido no tiene el mismo respaldo empírico que un artículo con datos y código publicados, aunque ambos estén en arXiv.
-
Usar preprints sin verificación cruzada en divulgación. Comunicar resultados preliminares como hallazgos definitivos contribuye a la desinformación científica, un riesgo acrecentado por los contenidos generados con IA.
Preguntas frecuentes sobre arXiv
¿arXiv es una revista científica? No. arXiv es un repositorio de preprints: aloja versiones preliminares de artículos que no han pasado por una revisión por pares tradicional. Muchos de esos trabajos se publican después en revistas, pero el propósito de arXiv es la difusión rápida y abierta.
¿Se puede publicar en arXiv sin afiliación universitaria? Sí, aunque existe un proceso de moderación más estricto para autores sin respaldo institucional o con poco historial en la plataforma. La mayoría de envíos proviene de investigadores afiliados a universidades o centros de investigación.
¿Los artículos de arXiv son gratuitos y de libre uso? La lectura es completamente gratuita. En cuanto al uso, cada artículo define sus condiciones mediante licencias; la mayoría permite compartir y reutilizar el contenido con atribución, pero conviene verificar la licencia específica antes de reutilizar figuras o texto.
¿Qué diferencia hay entre arXiv y bioRxiv o medRxiv? Comparten el modelo de preprint, pero se especializan en áreas distintas: arXiv cubre principalmente física, matemáticas e informática, mientras bioRxiv y medRxiv se centran en biología y medicina, respectivamente. arXiv fue el precursor de este modelo, creado en 1991.
¿Puedo escribir mi artículo en español y subirlo a arXiv? Desde febrero de 2026, no directamente: todos los envíos deben estar íntegramente en inglés o incluir una traducción completa a ese idioma. Las traducciones asistidas por herramientas de IA están permitidas, pero el autor es responsable de su exactitud.
¿Cómo sé si un preprint es confiable? No existe una garantía absoluta, pero algunos indicadores ayudan: la trayectoria de los autores, si el código y los datos están disponibles, si el trabajo fue después aceptado en una revista revisada por pares y si otros equipos han replicado los resultados. La evaluación crítica sigue siendo responsabilidad del lector.
RECuerde que…
arXiv demuestra que el acceso abierto al conocimiento no es una utopía, sino una infraestructura que funciona desde hace más de tres décadas y que acaba de superar los 3 millones de artículos. Para estudiantes, docentes e investigadores de Latinoamérica, dominar su uso representa una ventaja concreta: estar al día de la ciencia global sin barreras de pago ni de intermediarios. La clave está en el equilibrio entre aprovechar su velocidad y mantener el rigor crítico que exige todo resultado provisional.
Si desea profundizar en herramientas digitales para la investigación, la educación y la productividad con inteligencia artificial, encontrará más contenidos relacionados en FernandoJuca.com, además de videotutoriales y pódcast en el canal de YouTube de Fernando Juca Maldonado.