Tabla de Contenido
ToggleEquidad en el análisis de datos: por qué una conclusión verdadera puede ser injusta
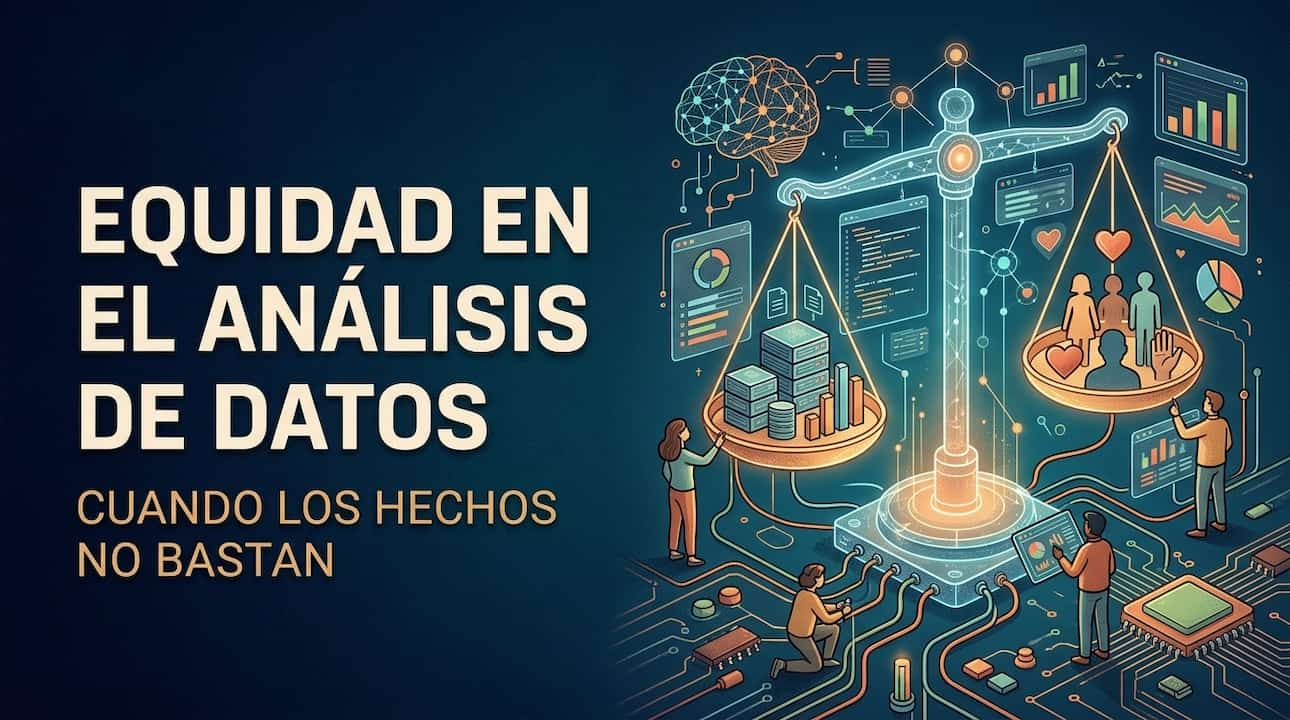
Los datos se basan en hechos recopilados. ¿Cómo puede ser injusto algo que se sustenta en hechos? La pregunta es razonable, pero la respuesta es incómoda: la equidad en el análisis de datos no depende solo de que los números sean correctos, sino de que las conclusiones que se extraen de ellos no refuercen ni creen sesgos. Un analista puede presentar una conclusión técnicamente verdadera que, al mismo tiempo, sea profundamente injusta porque ignora el contexto, omite variables relevantes o perpetúa una situación de desigualdad preexistente. Entender esta diferencia es uno de los desafíos más importantes del trabajo con datos.
El caso del “club de chicos”: cuando los datos reflejan el problema, no la solución
Imagina una empresa conocida por ser un club de chicos. No hay mucha representación de otros géneros. La dirección quiere saber a qué empleados les va bien, así que empieza a recopilar datos sobre el desempeño y la cultura interna. Los datos muestran que los hombres son los únicos que tienen éxito en esa empresa. La conclusión lógica, si se mira solo el número, sería contratar a más hombres. Después de todo, ahí les va muy bien.
Pero esa conclusión no es justa por dos razones. Primero, no tiene en cuenta todos los datos disponibles sobre la cultura empresarial, por lo que presenta un panorama incompleto. Segundo, no considera los factores circundantes que afectan a esos datos: la conclusión ignora las dificultades que enfrentan las personas de diferentes identidades de género al intentar navegar en un entorno laboral tóxico. Si la empresa se limita a analizar esa conclusión, no reconocerá ni abordará lo perjudicial de su cultura, y no entenderá por qué ciertas personas tienden a fracasar dentro de ella.
Un analista ético puede llegar a una conclusión distinta y más justa: la cultura de la empresa impide que algunos empleados tengan éxito, y la organización debe abordar esos problemas para mejorar el rendimiento. Esa conclusión pinta un panorama mucho más completo, reconoce el hecho de que a algunas personas no les va tan bien y explica por qué, en lugar de discriminar a un gran número de solicitantes en el futuro.
El sesgo no siempre es intencional: el caso de los “gemelos digitales”
La investigación reciente ofrece ejemplos concretos de cómo los sistemas automatizados pueden reproducir sesgos incluso cuando no hay una intención discriminatoria. Un experimento del Pew Research Center publicado en septiembre de 2026 puso a prueba la idea de que los modelos de IA podían sustituir a encuestados humanos. Se crearon “gemelos digitales” con las características demográficas de personas reales y se les pidió responder casi 300 preguntas de encuestas previas. Los resultados fueron reveladores: las respuestas generadas por la IA se desviaron de las humanas en un promedio de 12 puntos porcentuales, y en el 28% de las preguntas la diferencia superó los 15 puntos .
Algunos ejemplos ilustran la magnitud del problema. La IA estimó que el 97% de los adultos hispanos seguirían el Mundial de fútbol al menos en cierta medida; la cifra real era del 43%. Estimó que el 95% de los republicanos tenían una visión favorable de Israel; el dato real era del 58%. Y estimó que el 86% de los demócratas consideraban que los multimillonarios eran malos para el país; la cifra real era del 45% . El modelo no estaba “mintiendo” en el sentido tradicional: estaba tomando actitudes que son algo más comunes en un grupo y convirtiéndolas en estereotipos. Además, los participantes humanos eligieron “no estoy seguro” aproximadamente cuatro veces más a menudo que la IA, lo que sugiere que los modelos generan certeza donde las personas reales tienen dudas .
Este caso es relevante para la equidad en el análisis de datos porque demuestra que un sistema puede ser técnicamente sofisticado y, aun así, producir conclusiones distorsionadas sobre grupos humanos. Si una empresa utilizara estos “gemelos digitales” para tomar decisiones sobre productos, campañas o políticas, estaría actuando sobre una representación falsa de la realidad.
El enfoque de “equidad por diseño”: el proyecto Stroke Belt
Un ejemplo de cómo incorporar la equidad desde el inicio proviene de un equipo de científicos de datos de Harvard que desarrolló una plataforma móvil para rastrear pacientes con riesgo de enfermedad cardiovascular en una zona de Estados Unidos conocida como Stroke Belt. El equipo reconoció que la equidad debía ser una prioridad y tomó varias medidas concretas. Asociaron a analistas con científicos sociales que pudieran aportar información sobre los prejuicios humanos y el contexto social que los crea. Recopilaron datos autodeclarados en un sistema separado para evitar la posibilidad de sesgo racial. Y sobremuestrearon los grupos no dominantes para asegurarse de que el modelo los incluyera y la muestra fuera representativa .
Este enfoque, que los investigadores denominaron “fairness by design” (equidad por diseño), se inspira en el concepto de “privacidad por diseño” popularizado por el GDPR. La idea es sencilla pero poderosa: la equidad no se añade al final del proceso, sino que se integra desde la primera decisión sobre qué datos recopilar y cómo hacerlo .
Preguntas frecuentes sobre equidad en el análisis de datos
¿Qué significa equidad en el análisis de datos?
Significa garantizar que el análisis no cree ni refuerce sesgos. Implica ayudar a construir sistemas justos e inclusivos, teniendo en cuenta el contexto social y las desigualdades preexistentes.
¿Puede una conclusión basada en datos ser verdadera e injusta a la vez?
Sí. El caso del “club de chicos” lo ilustra: es cierto que solo los hombres tienen éxito en esa empresa, pero concluir que hay que contratar a más hombres ignora por qué ocurre y perpetúa una cultura tóxica.
¿Qué es el sesgo de muestreo?
Ocurre cuando los datos utilizados para entrenar un modelo no son representativos de la población a la que se pretende servir. Por ejemplo, un estudio sobre discriminación housing realizado solo en un barrio blanco no refleja la experiencia de las minorías .
¿Cómo se puede incorporar la equidad desde el inicio de un proyecto?
Definiendo qué datos se necesitan, consultando a expertos en contexto social, recopilando datos de forma separada para evitar sesgos y asegurando que la muestra sea representativa mediante técnicas como el sobremuestreo de grupos no dominantes.
¿Los modelos de IA son neutrales?
No. Los modelos aprenden de datos que reflejan el mundo tal como es, con sus desigualdades. Si no se corrigen, pueden reproducir y amplificar esos sesgos, como demostró el experimento de Pew con los “gemelos digitales”.
¿Qué responsabilidad tiene el analista de datos?
Es su responsabilidad asegurarse de que el análisis sea justo y tenga en cuenta el complicado contexto social que podría sesgar las conclusiones. La equidad debe estar presente desde la recopilación hasta la presentación de resultados.
Recuerde que…
La equidad en el análisis de datos no es un añadido técnico ni una casilla que se marca al final. Es una forma de pensar que acompaña todo el proceso, desde la primera pregunta hasta la última diapositiva. Los datos no hablan por sí solos: siempre hay alguien que decide qué medir, cómo medirlo y qué hacer con los resultados. Ese alguien tiene la responsabilidad de preguntarse no solo si la conclusión es verdadera, sino si es justa. Porque una conclusión puede ser precisa y, al mismo tiempo, profundamente injusta. Y detectar esa diferencia, a tiempo, es lo que separa a un analista competente de uno verdaderamente ético.
Pueden encontrar más contenido en https://fernandojuca.com, así como videotutoriales y pódcast en https://youtube.com/fernandojucamaldonado.
Fuentes:
-
Pew Research Center: experimento con “gemelos digitales” y encuestas sintéticas (citado en AI Weekly y Bhavnagar Police)
-
McIntire School of Commerce: “Fairness by Design” en el proyecto Stroke Belt (Harvard Business Review)
-
Zentner, A.: “Addressing Unconscious Bias in Data Science: A Primer for Emerging Data Scientists”